Erro ".vbm is not synchronized with the DB" no Veeam Cloud Connect: como resolver
Passo a passo para resolver o erro de metadado dessincronizado em jobs de Veeam Agent gerenciados por VSPC gravando em Scale-out Repository. Diagnóstico, causa e solução.
Este é um daqueles erros em que a própria mensagem diz o que fazer — e a instrução não funciona onde você está lendo. O job de um agente para de rodar com a queixa de que o arquivo de metadado não está sincronizado com o banco, e manda rodar um repository rescan. Só que, no console onde o erro aparece, esse rescan não existe.
O cenário é o de provedor de serviços: Veeam Cloud Connect rodando na nossa infraestrutura, jobs de Veeam Agent gerenciados por policy no Veeam Service Provider Console (VSPC), gravando em um Scale-out Backup Repository (SOBR) sobre object storage. Um ou mais jobs de tenant começam a falhar na inicialização e não saem mais do lugar.
O sintoma
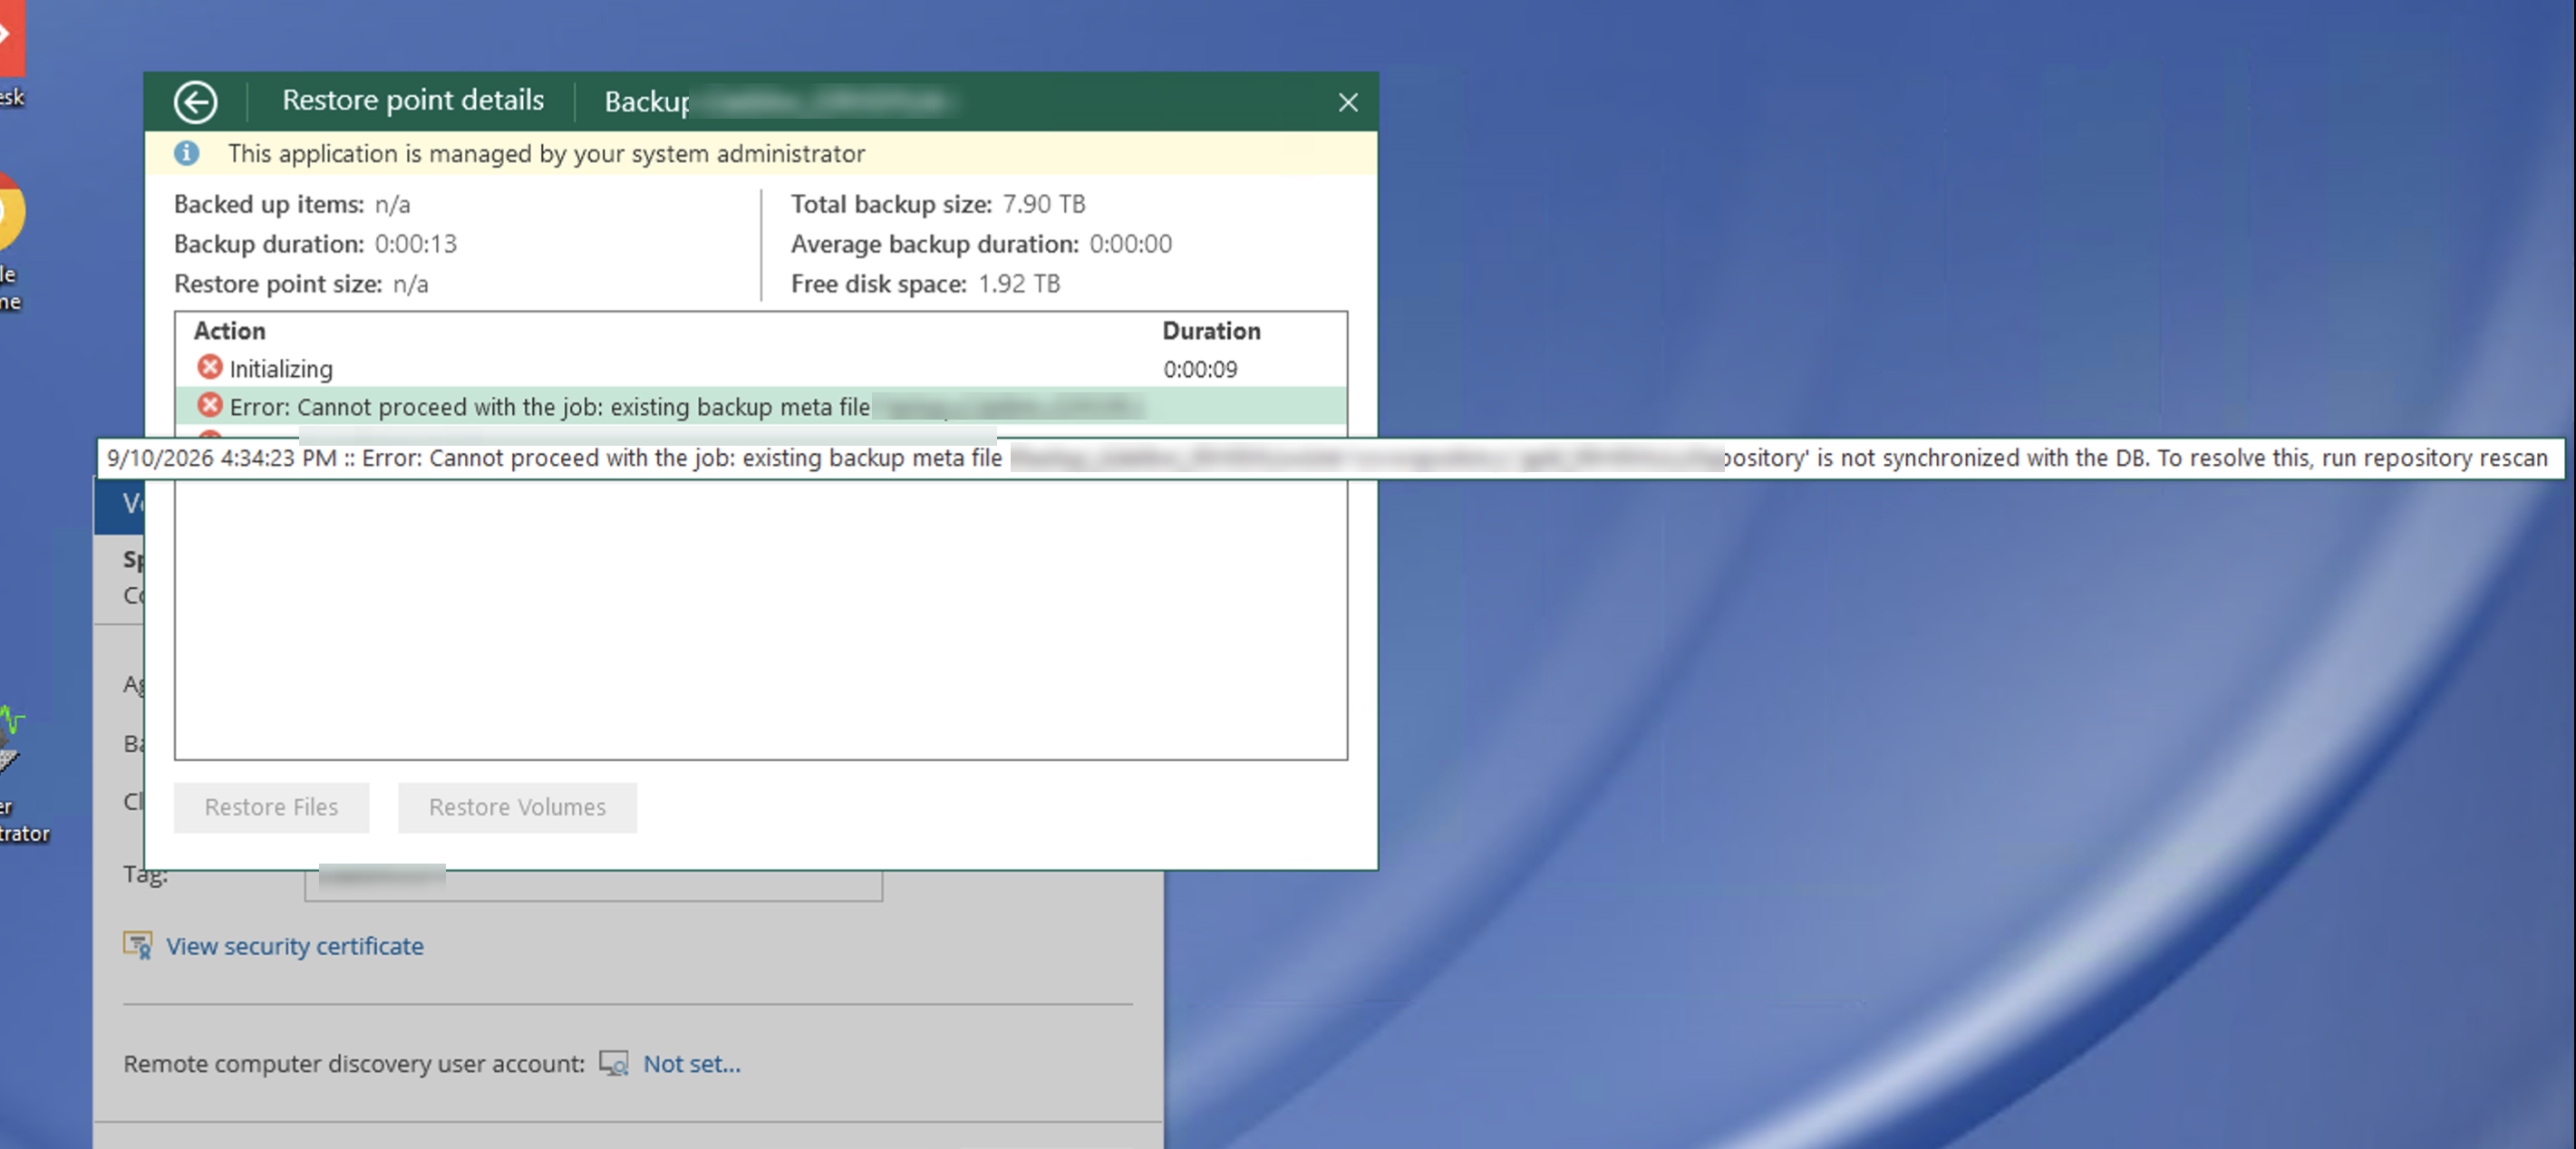
O job do agente falha ainda na fase Initializing, sempre com a mesma mensagem:
Error: Cannot proceed with the job: existing backup meta file
'Backup_<Nome>.vbm' on repository '<repo>_Repository' is not
synchronized with the DB. To resolve this, run repository rescan
No VSPC o job aparece com status Failed e 0 of 1 restore points, mesmo que o Backup Size ainda mostre o volume da cadeia antiga. A falha se repete a cada tentativa agendada, sem nunca evoluir — não é lentidão nem timeout: o job é reprovado antes de tocar em dado.
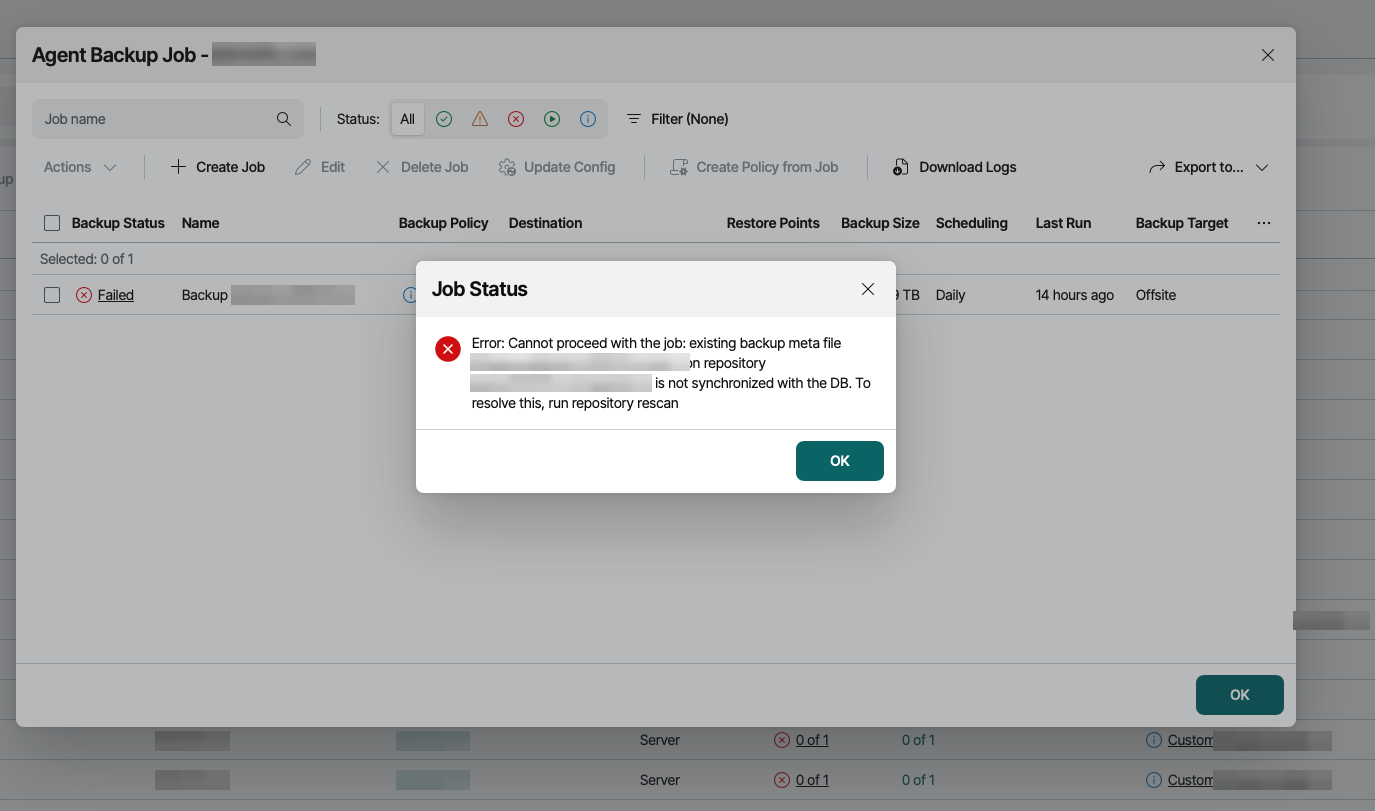
Identificadores de cliente — nome do tenant, do job, do arquivo e dos servidores — foram borrados nas capturas deste post.
O que está acontecendo
O arquivo .vbm é o metadado da cadeia de backup. Ele descreve quais pontos existem, em que ordem e a quem pertencem. O erro aparece quando o que está gravado no .vbm dentro do storage não bate com o registro daquela cadeia no banco de configuração do Veeam, do lado do provedor.
Quando isso acontece, o Veeam se recusa a escrever na cadeia. É proteção deliberada: escrever sobre um metadado divergente corromperia os pontos que já existem. O job falhando é o comportamento correto — o problema é a divergência, não a recusa.
Três pontos explicam por que os caminhos “óbvios” não resolvem:
- A verificação acontece do lado do provedor, não do agente. O agente apenas pergunta ao Cloud Connect se o metadado está sincronizado (
IsMetaFilesSynchronizedWithDb); quem responde “não” é o servidor do provedor. Reiniciar o serviço do agente, reinstalar o agente ou reempurrar a configuração da policy não muda essa resposta. - O agente não consegue rodar o rescan que a mensagem pede. No log do agente aparece, com todas as letras:
Repository rescan is not supported. Repository is not gated object storage repository. A instrução da mensagem só faz sentido executada no repositório de backend, do lado do provedor. - Quando o backend é um SOBR, o rescan tem que ser no SOBR — não na extent individual de object storage. Um SOBR multi-extent é justamente o arranjo que produz esse tipo de dessincronia quando uma extent muda de estado.
Gatilhos comuns
- Uma extent do SOBR entrou em maintenance mode, foi selada, adicionada ou removida.
- Restore de configuração do servidor Veeam.
- Tenant ou subtenant recriado ou re-registrado, deixando a cadeia antiga com dono órfão.
- Máquinas que transitaram entre tenants — por exemplo, de um tenant principal para um tenant de trial.
Como diagnosticar
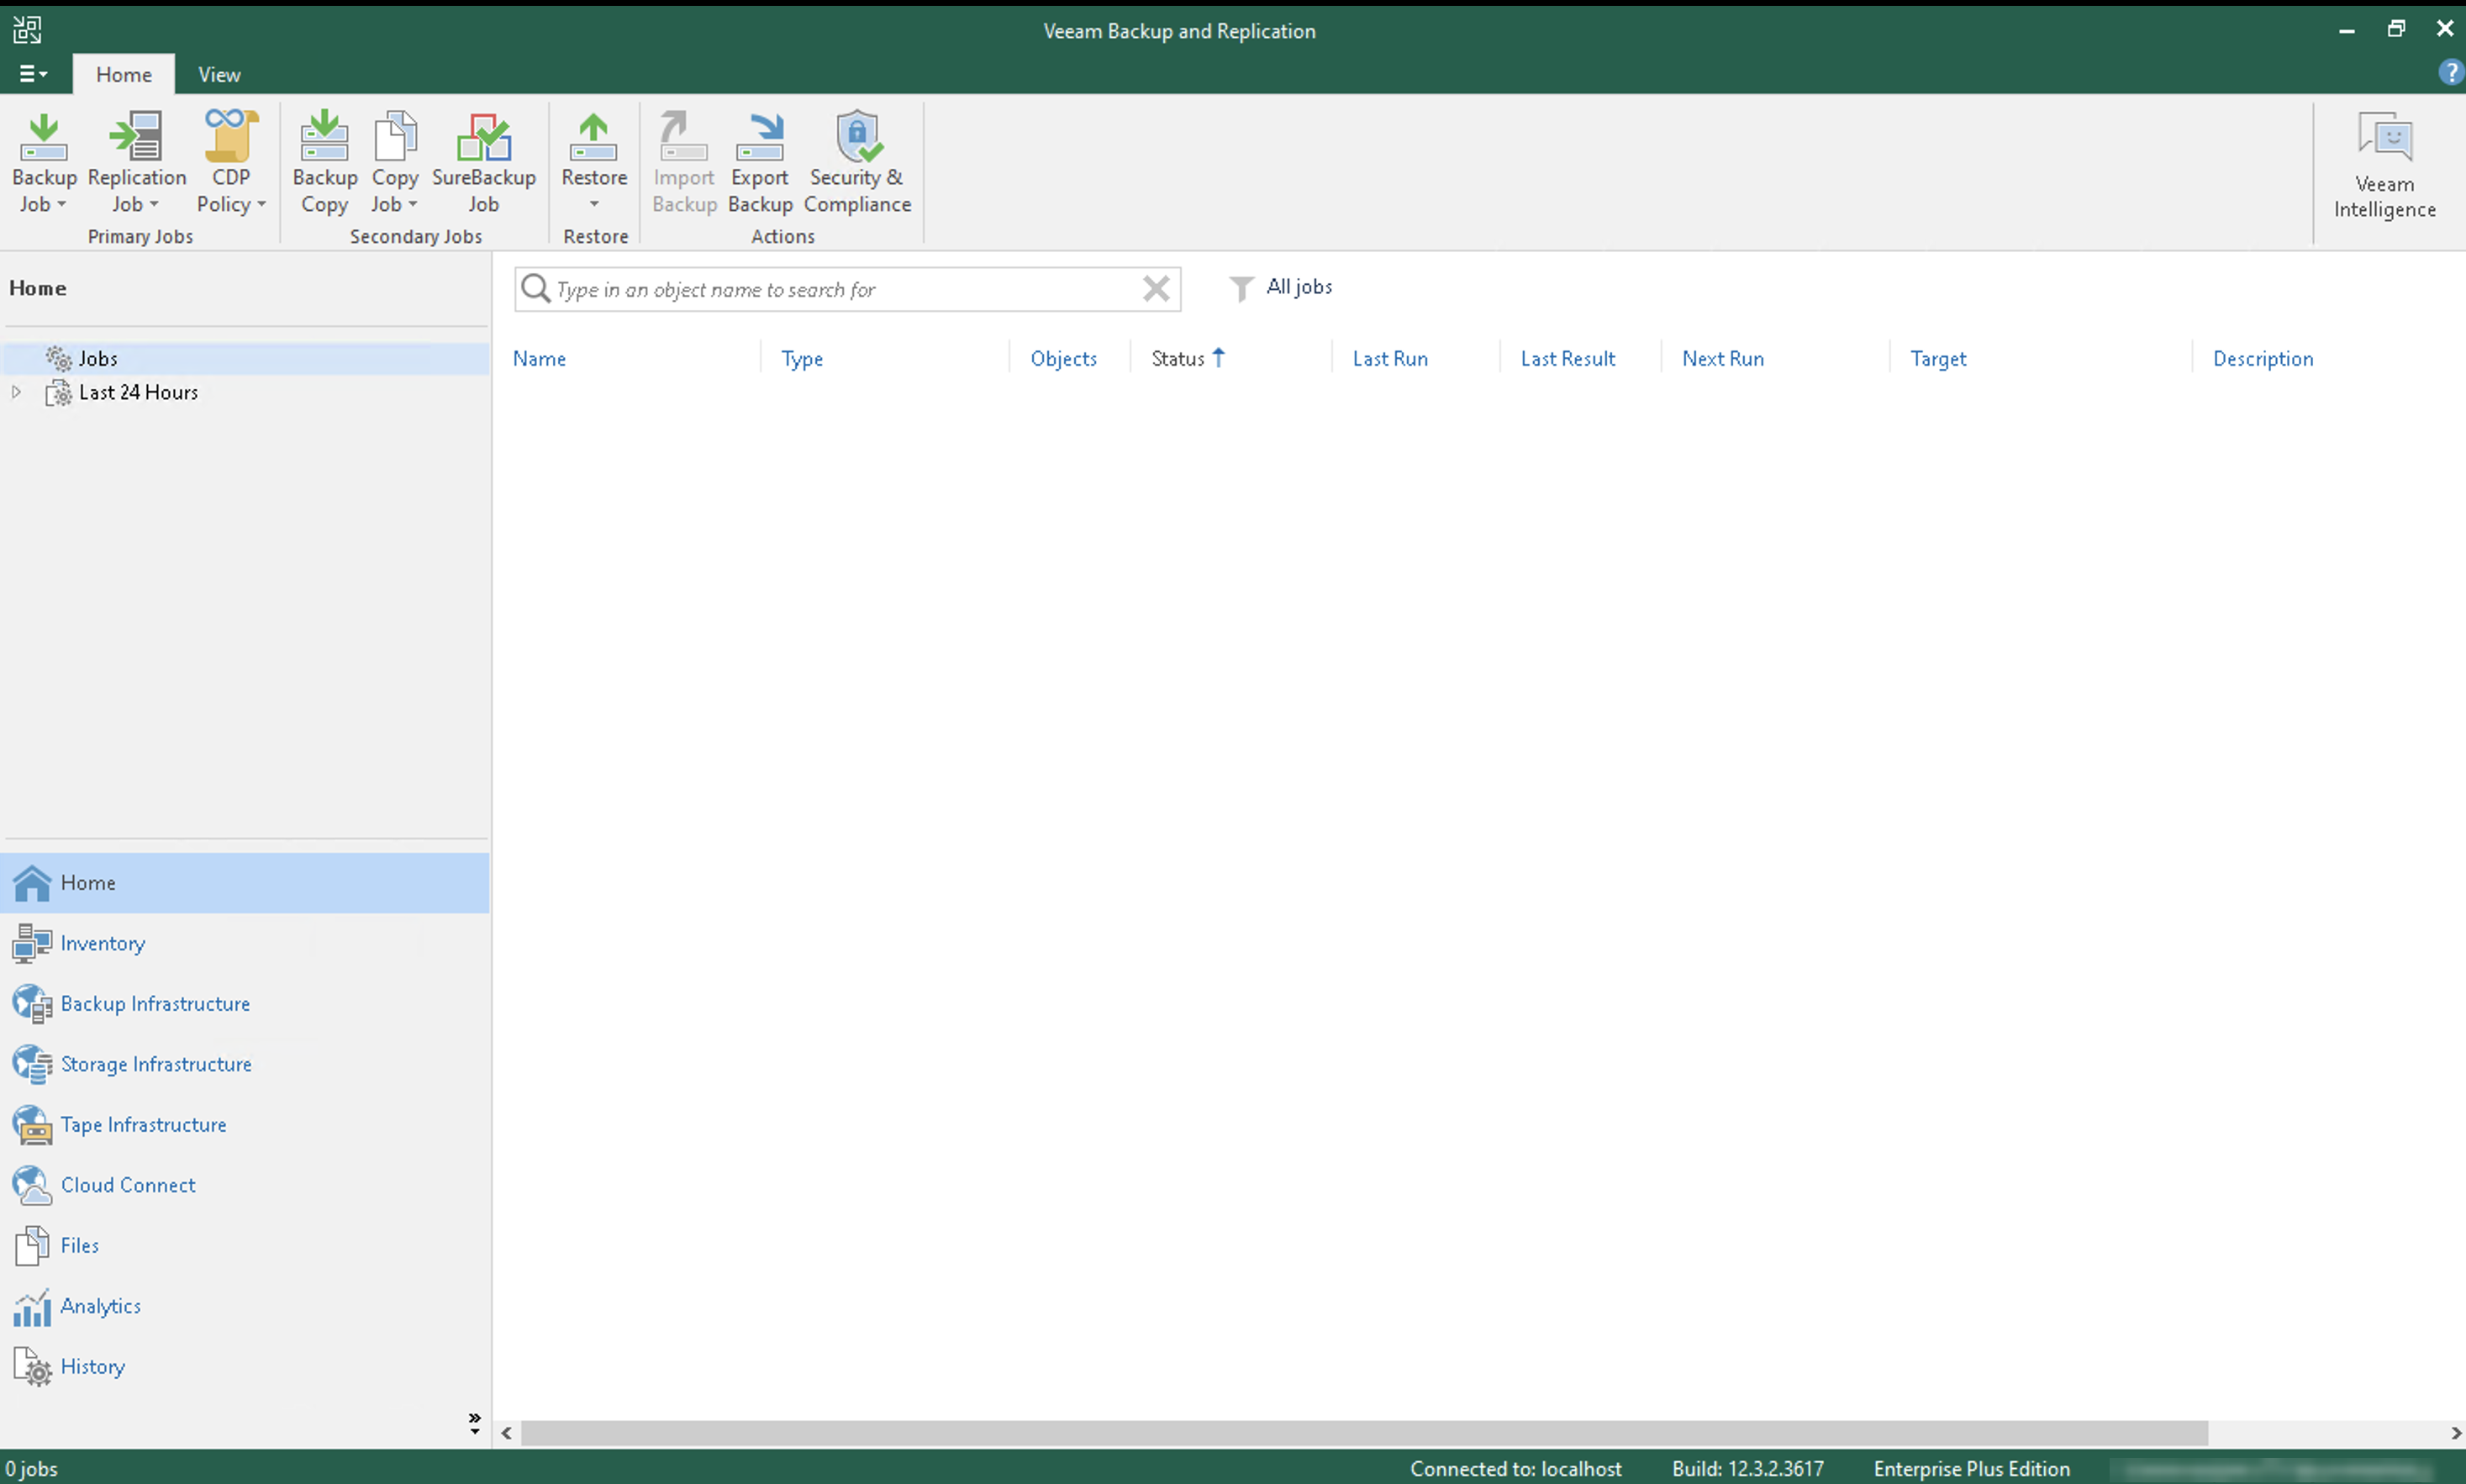
1. Confirme em qual console o erro nasce
No console do provedor (Cloud Connect), o nó Home → Backups sempre estará vazio por design: o provedor não enxerga as cadeias dos tenants, apenas o consumo de quota. “Não aparece backup aqui” é comportamento esperado, não sintoma — e é o primeiro desvio de investigação que costuma custar tempo.
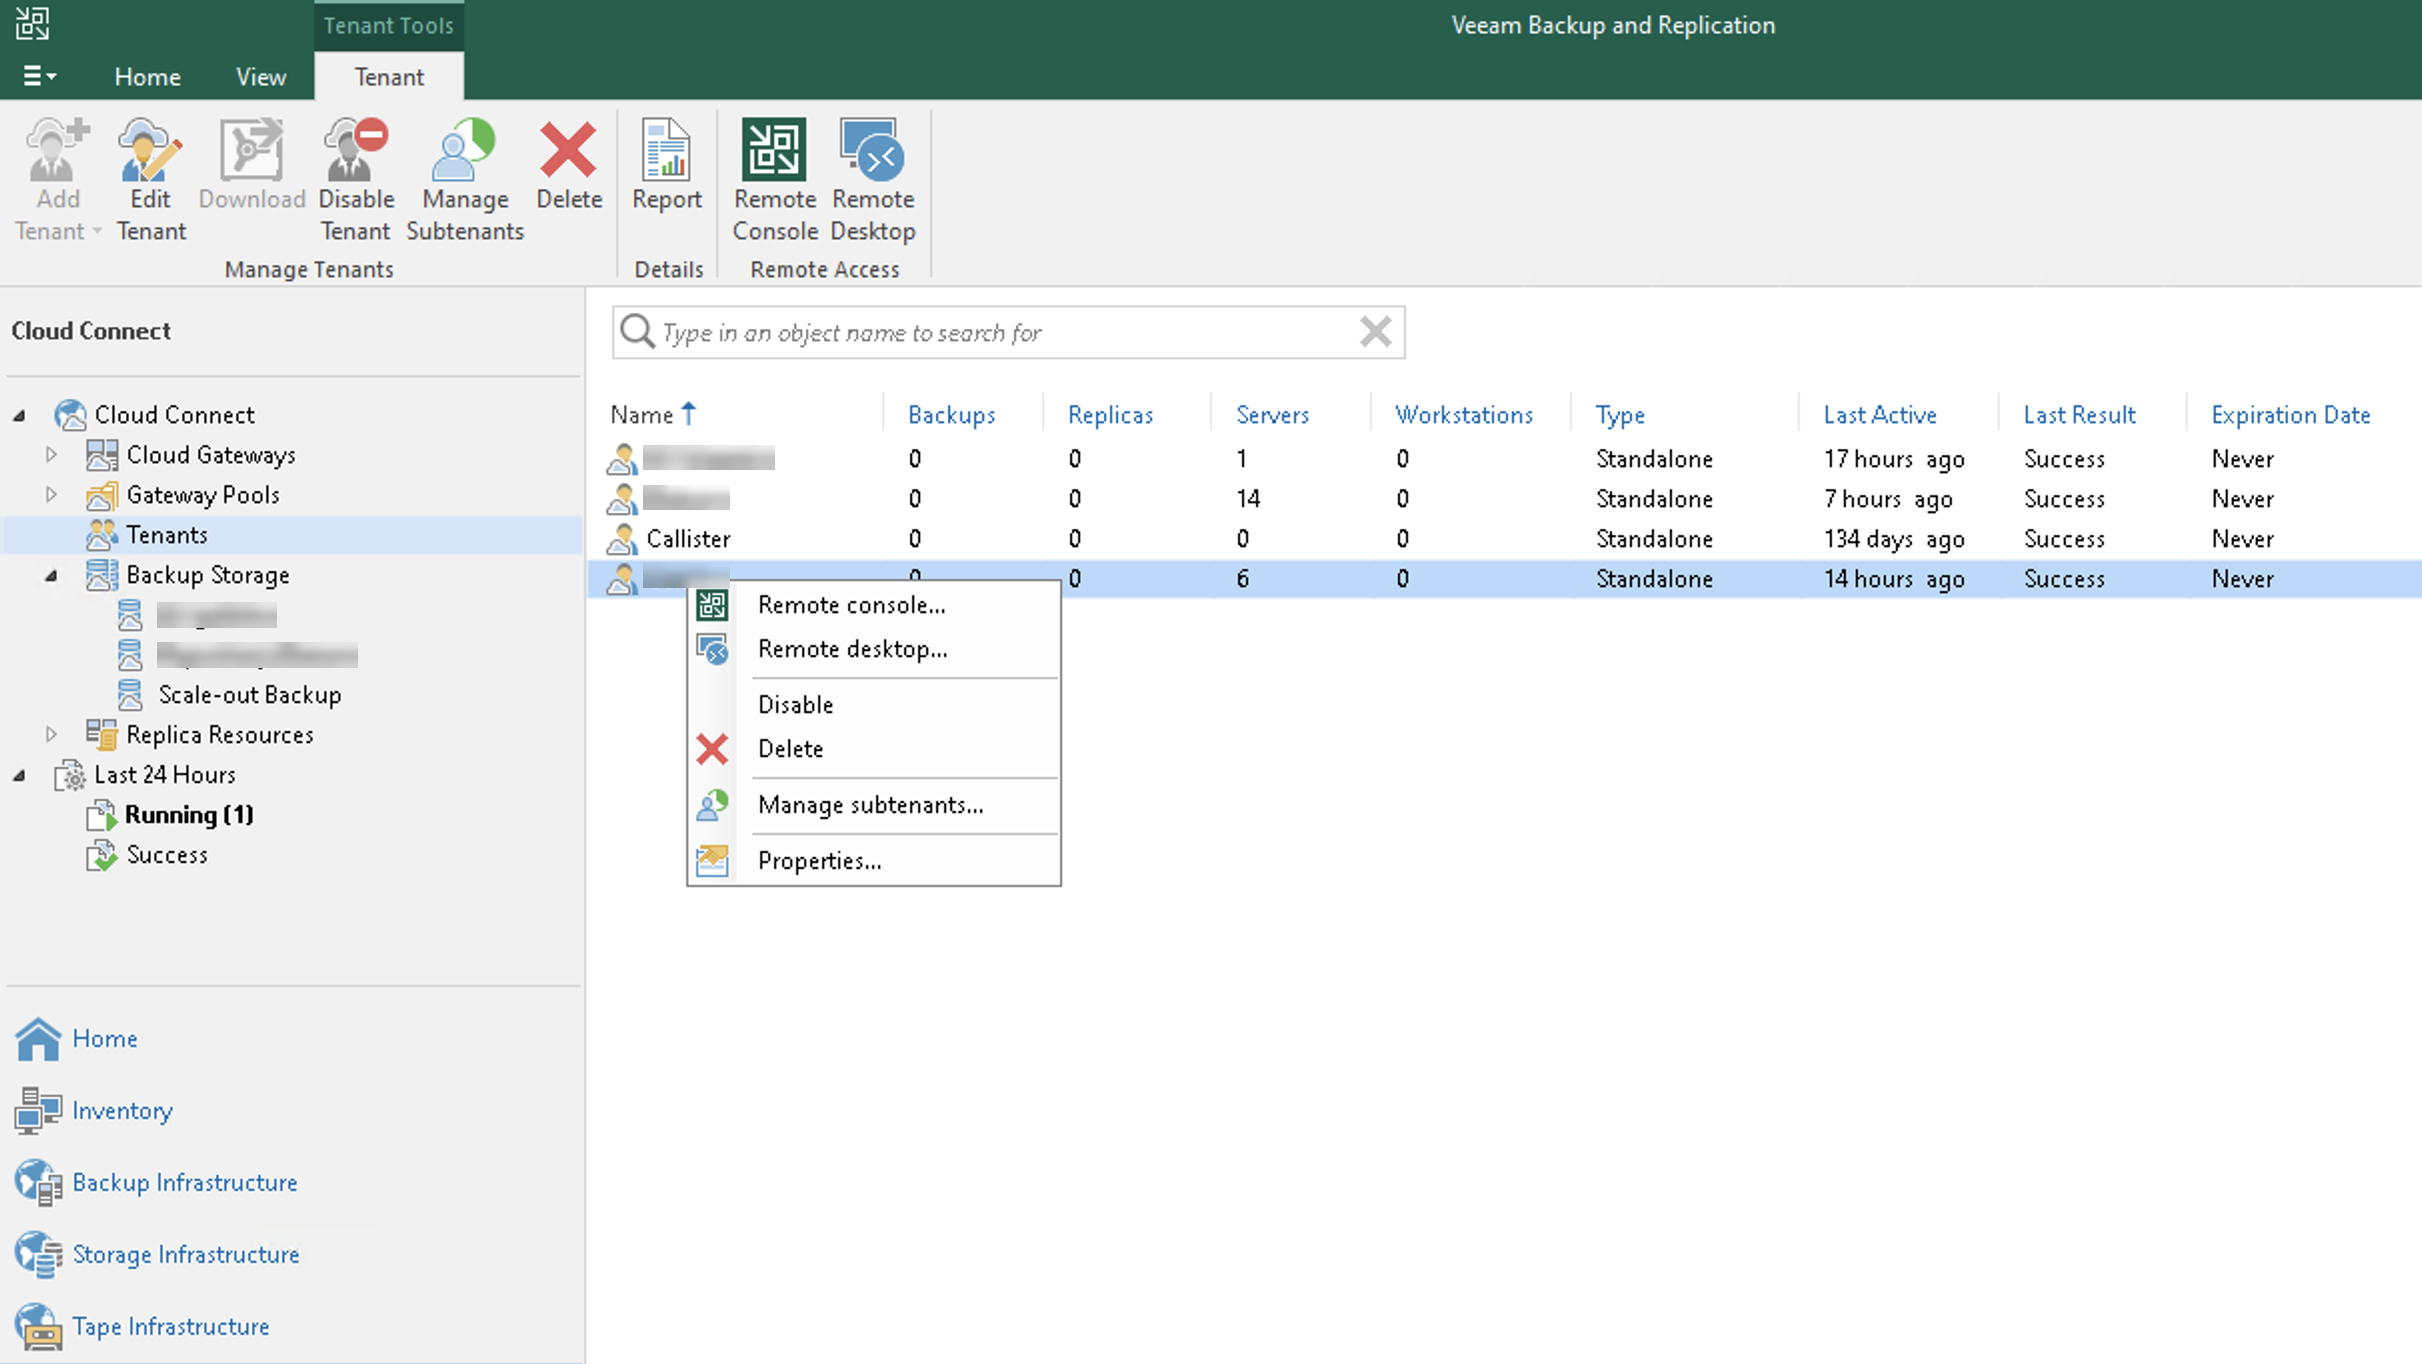
2. Localize o tenant e o repositório de backend
Vá em Cloud Connect → Tenants, localize o tenant afetado e abra a aba Backup Resources. É aqui que se identifica qual repositório de backend sustenta a quota — no nosso caso, um Scale-out Backup Repository. Esse é o objeto em que a correção será aplicada.
3. Leia os logs do job
Opcional, mas conclusivo. Em Download Logs no VSPC, procure a sequência que fecha o diagnóstico:
[SC.IsMetaFilesSynchronizedWithDb] RepositoryId:... → CIResult:False
Repository rescan is not supported. Repository is not gated object storage repository
Cannot proceed with the job: existing backup meta file ... is not synchronized with the DB
As três linhas juntas confirmam que a correção precisa ser feita no backend do provedor, e não no agente. Anote os IDs que aparecem no log — JobId, BackupId, QuotaId. Se o caso escalar para o suporte Veeam, eles encurtam o chamado.
A solução
Passo 1 — Rescan do Scale-out Repository
No console do provedor:
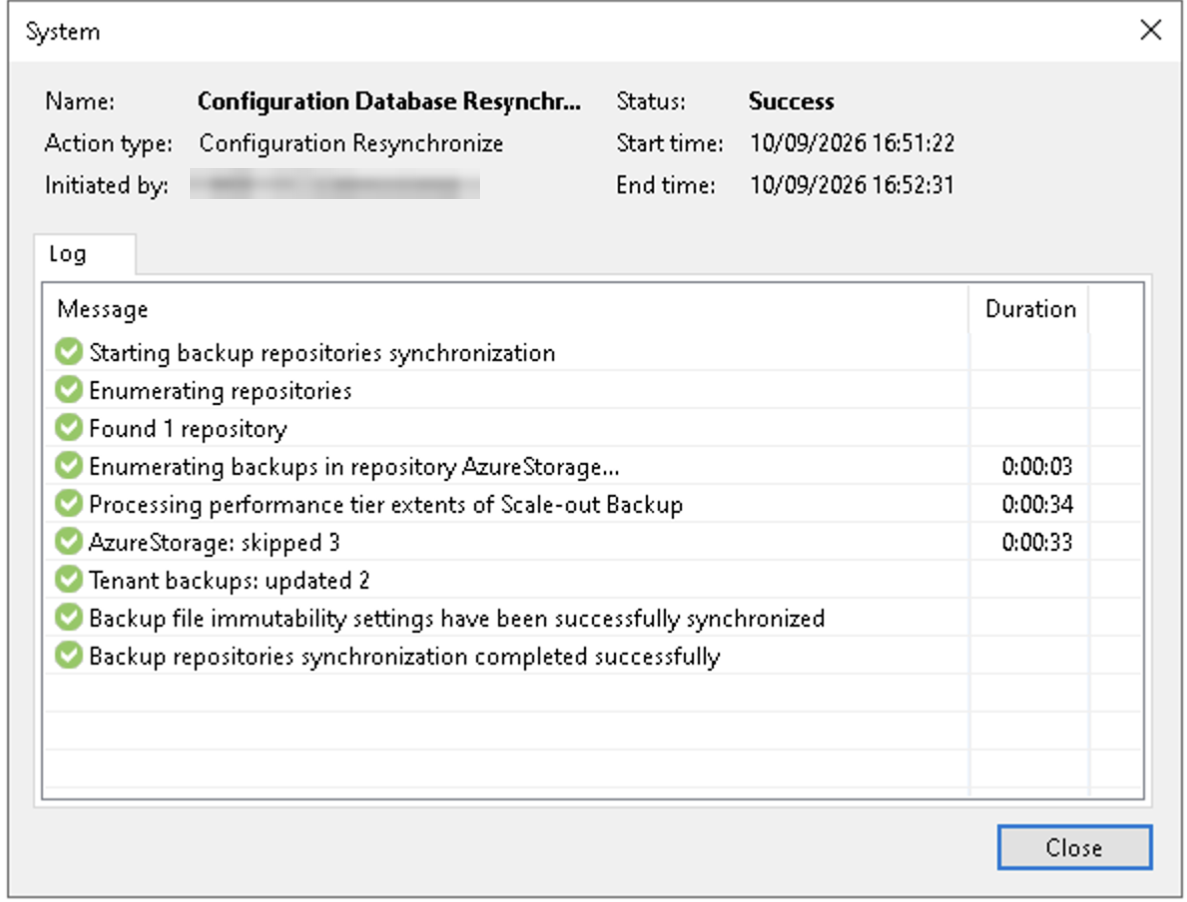
Backup Infrastructure → Scale-out Repositories → [selecione o SOBR] → Rescan RepositoryAcompanhe o progresso em History → System até concluir. Com vários TB em object storage, o processo demora — deixe rodar.
O rescan bem-sucedido reconcilia o banco. As linhas-chave no log de sistema são:
Processing performance tier extents of Scale-out BackupTenant backups: updated N— este é o indicador de que cadeias de tenant foram corrigidas no bancoBackup file immutability settings have been successfully synchronizedBackup repositories synchronization completed successfully
Se o rescan terminou em Success mas não apareceu Tenant backups: updated N, nenhuma cadeia de tenant foi tocada — e o job provavelmente vai falhar de novo. Vá direto ao Passo 4.
Passo 2 — Rode o job novamente
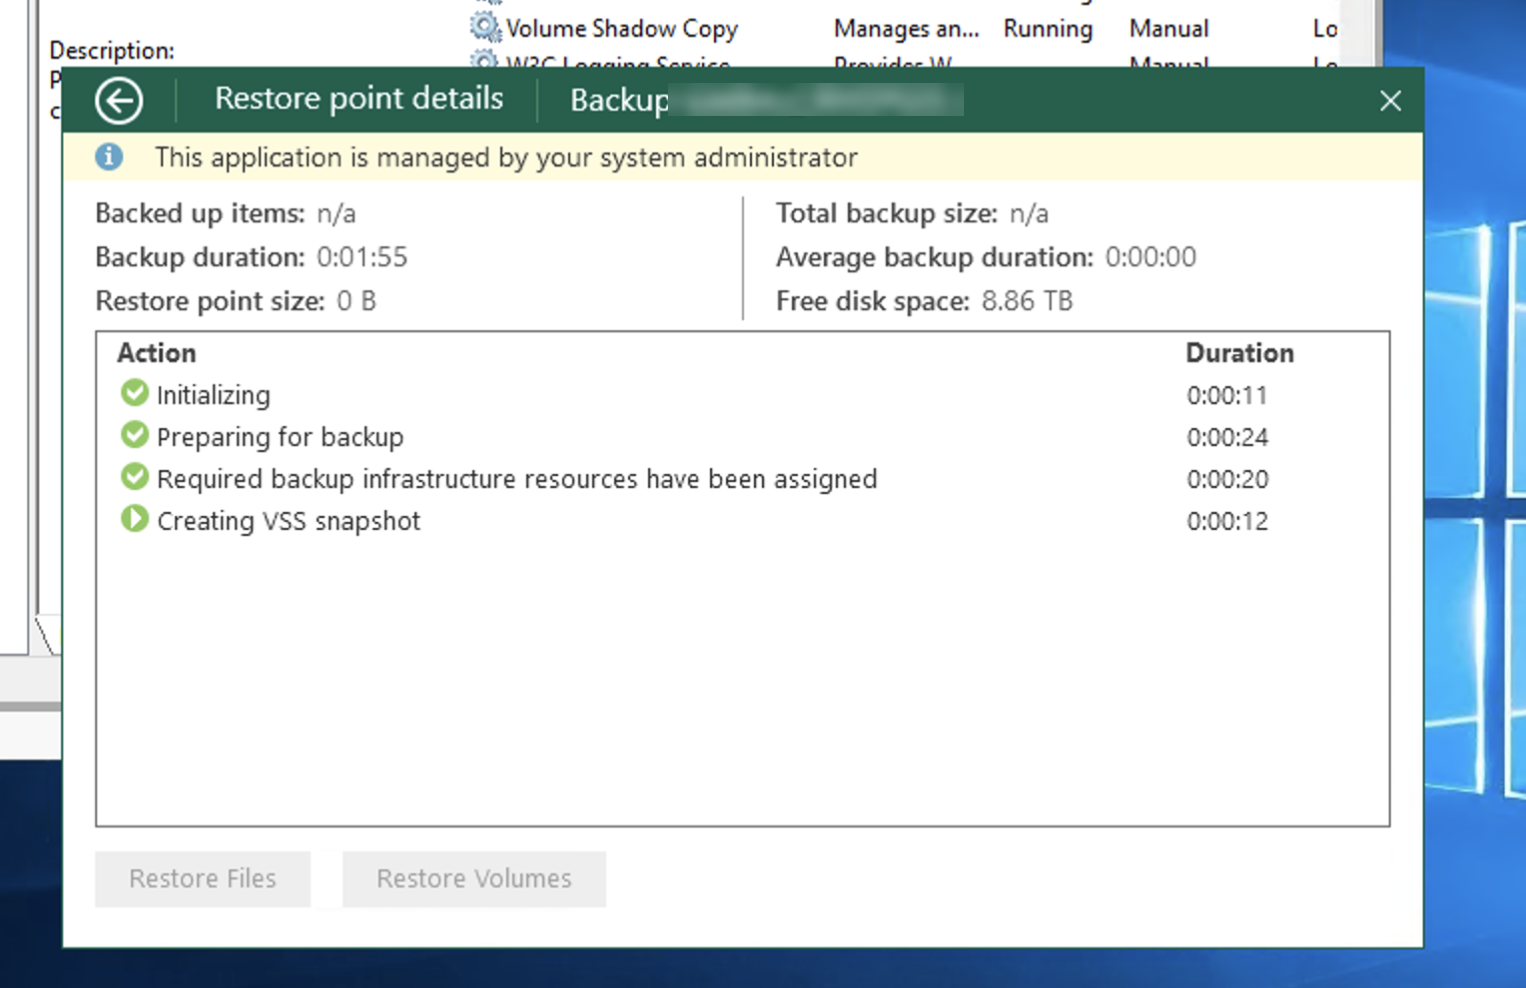
Com o banco reconciliado, dispare o job manualmente, pelo VSPC ou no VBR do tenant. A verificação que reprovava o job consulta exatamente o registro que o rescan acabou de corrigir. Se a correção pegou, o job passa da fase Initializing e segue para Preparing for backup, alocação de recursos de infraestrutura e criação do snapshot VSS.
Passar do Initializing é o sinal de sucesso. O resto do job volta a ser um backup comum.
Passo 3 — Repita para os demais jobs afetados
Se mais de um tenant ou servidor apontava para o mesmo SOBR, é comum que todos tenham quebrado juntos — e todos voltam com o mesmo rescan. Dispare cada um e confirme que passam da inicialização, em vez de esperar a janela agendada.
Passo 4 — Se o rescan não resolver
Se o job continuar falhando com a mesma mensagem depois do rescan, o .vbm está órfão de fato: o dono da cadeia não existe mais no banco. A partir daí há dois caminhos, e nenhum é indolor:
- Chamado no suporte Veeam (contrato VCSP). Como a console do provedor não expõe a cadeia do tenant, remover a entrada órfã do banco não é operação de interface. Abra o chamado com os IDs coletados no diagnóstico.
- Descartar a cadeia antiga e recomeçar. Liberar a pasta/quota do subtenant e rodar um active full novo resolve, ao custo de perder os restore points existentes. Só faça isso depois de confirmar a retenção contratada e verificar se há imutabilidade (Object Lock) ativa — com Object Lock, a exclusão nem sequer é possível até vencer o período.
Cuidado com a retenção enquanto o job está parado
Se o job ficou dias falhando, há um detalhe que engana muita gente e leva a mudanças desnecessárias na policy:
- A retenção do Veeam é por número de restore points, não por data de calendário. “7 dias” significa, na prática, “manter os 7 pontos mais recentes”.
- Enquanto o job falha, nenhum ponto novo é criado, então nada é apagado pelo relógio. Os pontos antigos continuam lá, intactos.
- Não é necessário nem eficaz subir a retenção antes de rodar o backup. O mecanismo de retenção só é avaliado quando um ponto novo entra na cadeia.
- Se quiser preservar um ponto bom antigo por garantia, aumente a retenção depois que a cadeia voltar a rodar. E se o job é gerenciado por policy do VSPC, altere a retenção na Backup Policy do VSPC — mexer direto no tenant faz o console sobrescrever a mudança na próxima sincronização.
Resumo rápido
| Etapa | Ação |
|---|---|
| Causa | Metadado .vbm da cadeia diverge do banco de configuração do provedor |
| Onde corrigir | No provedor, nunca no agente — o agente não suporta o rescan |
| Correção | Backup Infrastructure → Scale-out Repositories → Rescan Repository |
| Confirmação | Linha Tenant backups: updated N no log de sistema |
| Validação | O job passa da fase Initializing |
| Escopo | Todos os jobs no mesmo SOBR voltam com um único rescan |
| Não resolveu | .vbm órfão: chamado Veeam ou active full, com cautela sobre retenção e imutabilidade |
| Retenção | Por contagem de pontos, não por data — não precisa mexer antes de rodar |
Por que isso importa na prática
O incidente inteiro se resolve em um rescan, mas o tempo perdido raramente está na correção: está em procurar o problema no lugar errado. A mensagem aponta para uma ação que só existe do outro lado da relação — e, sem entender que a validação é do provedor, dá para gastar horas reinstalando agente e reempurrando policy.
Vale também o pós-mortem: jobs que ficam dias falhando em silêncio são um problema de monitoramento, não de backup. Um ambiente gerenciado detecta a primeira falha, não a sétima. Se este erro apareceu para você depois de uma semana sem ponto novo, o alerta é aí.
Se o assunto for recuperação de máquina inteira a partir de um backup de agente, o caminho é outro — cobrimos ele no post sobre bare metal recovery com Veeam Agent for Windows. Para entender o arranjo de repositório que está por trás deste cenário, veja Veeam Cloud Connect: backup offsite.
Quer backup gerenciado por quem opera a infraestrutura do outro lado e monitora a falha no primeiro dia? Conheça nosso serviço de backup gerenciado ou fale com a gente.
Artigos relacionados
Precisa de ajuda com segurança de redes?
Fale com um especialista certificado SonicWall e Fortinet.
Falar com Especialista